为什么重回 RSS
我经常会在上查看 AI 相关的内容。这些年,越来越多高质量的信息,基本上都是首先出现在上。比如:
- @OpenAI 、@AnthropicAI、@GeminiApp 等相关科技企业。
- @sama、@ilyasut、@gdb 等科技公司创始人、核心研究者。
- @naval、@elonmusk、@justinsuntron、@paulg 等投资人、创业者与意见领袖。
- @ycombinator、@karpathy、@emollick、@levelsio 等长期分享 AI 实践与研究内容的创作者。
- @hwchase17、@jerryjliu0、@steipete 等开源项目作者与维护者。
很多时候,一些真正有价值的观点、实验、产品方向,往往最早就是从这些人的动态里流传出来的。但问题也很明显,的 Timeline 本质上是算法推荐流。当开始频繁浏览某类内容之后,系统会不断给你推荐更多相关内容。最开始你会觉得:“推荐得还不错。” 但慢慢地,问题就出现了,信息开始变得越来越杂。真正重要的信息,不断淹没,尤其是在 AI 圈,这种情况其实非常明显,因为热点变化太快。今天大家讨论 Agent。 明天讨论 Model Context Protocol。 后天又开始讨论新的模型。很多内容甚至只是:
- 情绪表达;
- 标题党;
- 重复二手信息。
以及另外一个问题:平台里的内容是多语言混杂的,虽然现在 X 已经提供了翻译功能,但很多时候阅读体验也会被打断。当然,还是有办法解决,比如:
- 创建列表 Lists,将固定的作者按照一定的类别创建不同的列表;
- 或者直接进入作者主页,手动翻阅内容。
这些方式其实都没问题,但新的问题又出现了,有时候时间有限,我只想了解:“某个人这一周到底重点关注了什么?”事情就开始变得麻烦。因为作者的 Timeline 里,往往混杂着:
- 回复;
- 转发;
- 临时讨论;
- 碎片化互动;
- 与主线无关的内容。
你需要手动一条条翻,而且很难形成稳定的信息沉淀,同时花费不少的时间。后来我开始意识到:我真正需要的,其实不是“更多信息”,而是:更干净、更稳定、更容易处理的数据源。尤其是在 LLM 时代,因为 LLM 很擅长:
- 总结;
- 分类;
- 提炼;
- 聚合;
- 分析。
但前提是:需要先给它一个相对干净的信息输入层,于是,开始尝试寻找一种:
- 更稳定;
- 更可控;
- 更适合长期订阅;
- 更适合 AI 自动处理;
的信息获取方式。而在这个过程中,我开始不断看到一个词: RSS 以及后来进一步了解到的:RSSHub
什么是 RSS
在继续研究的过程中,我开始重新了解RSS,说实话,在很长一段时间里,我一直觉得 RSS是一种“已经过时”的东西。因为社交媒体、推荐算法、短视频、AI 推荐流,几乎已经覆盖了大多数人的信息获取方式。但真正重新研究之后,发现:RSS 其实并没有消失。只是它从“普通用户工具”,慢慢变成了:一种更偏底层的信息获取协议。
RSS 本质上可以理解为:“一种开放的信息订阅协议”。 很多网站都会提供一个 RSS Feed 地址。
比如:
RSS客户端只需要订阅对应的 Feed,后续只要网站更新内容,就会自动收到,本质上是一种标准化的数据格式(通常是 XML) 核心思路:“你主动订阅信息源,而不是平台主动给你推荐内容。” 这和现在主流平台的信息流逻辑,完全是相反的,从
- 算法推荐;
- 无限滚动;
- 情绪驱动;
- 热点传播;
- 广告与商业化。
转换为:
- 一个干净的信息列表;
- 一个时间顺序的数据流;
- 一个没有算法干预的内容源。
没有:
- 推荐流;
- “猜你喜欢”;
- 情绪推送;
- 无限刷新。
它甚至有一种“过于安静”的感觉。但某种意义上:这恰恰是它现在重新变得有价值的原因。
RSS 在 AI 时代的新价值
以前很多人使用 RSS,更像是在:
- 订阅博客;
- 看新闻;
- 跟踪网站更新。
它更偏向“阅读工具”,但现在我越来越觉得: RSS的真正价值,其实已经变成了:“稳定的数据源”。 尤其是在 AI 大模型出现之后。因为:
- LLM;
- Agent;
- 自动化工作流;
- RAG;
- 信息聚合系统;
这些东西,本质上都需要:稳定、结构化、可持续获取的数据源。而 RSS恰好天然符合这些特点。
例如:
RSS → LLM → 总结 → Notion / Telegram / 邮件
或者:
RSS → 向量库 → RAG → AI 分析
很多以前“只能人工阅读”的内容,现在其实都可以开始自动化处理。RSS 的价值,可能从来都不是“阅读体验”,而是:“信息控制权”。
你订阅什么。
你获取什么。
你如何处理这些内容。
这些事情,重新回到了你自己手里,而不是平台算法手里。
RSSHub 是干什么的
伴随着RSS,搜索引擎和 LLM 经常会提到: RSSHub这个项目。
RSSHub 最核心的一句话其实非常直接: “把原本没有 RSS 的网站,转换成 RSS。” 这也是它真正有价值的地方。因为现在很多网站,其实已经不再提供 RSS 了。尤其是社交媒体平台。
比如:
- X
- Telegram
- YouTube 的某些页面
- Bilibili
- GitHub 的部分内容
- 各种论坛
- 社区网站
- 内容平台
有些平台:
而 RSSHub 做的事情,本质上就是: “把这些网站重新转换成标准 RSS Feed。” 你可以把它理解成: “一个 RSS 转换器。” RSSHub 内部有大量不同的网站“路由(Route)”。 不同路由对应不同网站的数据解析逻辑。
例如:
- 某个 X 用户
- 某个 Telegram Channel
- 某个 YouTube UP 主
- 某个 GitHub Release
- 某个 Bilibili 用户动态
RSSHub 会:
- 请求对应页面;
- 提取内容;
- 转换成 RSS XML;
- 最终生成一个标准 Feed 地址。
然后可以:
- 用 RSS 阅读器订阅;
- 用程序读取;
- 接入 AI 工作流;
- 做自动化处理。
通过检索,看到很多:
- AI 开发者;
- 独立开发者;
- 自动化玩家;
- 情报监控系统;
- 研究人员;
也在大量使用它。因为它解决的其实不是:“阅读问题”。而是在 AI 时代:“信息获取问题”。
- 一个现代化 RSS Reader;
- 一个信息订阅产品;
- 一个更偏普通用户的内容聚合工具。
某种意义上:RSSHub 像底层的数据层,而 Folo 像建立在这之上的“消费层”,感兴趣的可以去体验下。
作为开发者,还是更想自己动手。如果只是“订阅内容”这件事:直接使用现成产品,其实已经够了。 但对于开发者来说,很多时候真正感兴趣的,并不只是:“能不能用”。
而是:
- 数据是怎么获取的;
- Route 是怎么工作的;
- Feed 是怎么生成的;
- Cookie 是怎么参与请求的;
- 不同平台为什么有不同限制;
- 整个链路到底如何运行。
尤其是在 AI 时代,因为很多时候:你真正想做的,并不是“阅读”。
而是:
- 信息聚合;
- 自动化处理;
- LLM 分析;
- 数据清洗;
- 监控系统;
- Agent 工作流。
而这些事情的前提,往往是:你需要真正掌控数据输入层。 这也是为什么后来我还是决定:自己部署一套 RSSHub Instance。并实际去测试:
- X 路由;
- Cookie 配置;
- Feed 效果;
- 数据完整性;
- Timeline 差异;
- 稳定性;
以及整个系统的工作方式。
权衡与选择
在真正开始想做这件事的时候,最开始其实研究的是:X 官方 API
理论上:官方 API 肯定是最稳定、最正规、最完整的方案。但是个人使用场景来说,首先是成本,X API 采用: Pay-per-use(按量付费),没有免费额度。
比如:
- 读取 Posts
- 查询 Timeline
- 搜索内容
都会产生费用,对于企业来说可能还好,但如果只是个人小规模监控。这个成本会变得不太划算,除了费用之外,还有:支付方式等问题。尤其对于中国大陆的开发者来说:支付环节本身就已经有一定门槛。后来在检索相关方案的时候,我发现:很多人 和 LLM 都会推荐 RSSHub。尤其是:“个人低频订阅” 这种场景。因为从结果上来说:我真正想解决的问题,其实只是:
- 订阅少量作者;
- 获取更新;
- 给 AI 做分析;
- 做信息聚合。
而不是真的去做:
- 大规模数据抓取;
- 商业 API 服务;
- 高并发系统。
RSSHub 也不是官方支持的方案,尤其是针对 X 这类平台。本质上还是依赖:
- 页面解析;
- Cookie;
- 抓取逻辑;
- 第三方路由。
因此天然会存在一些问题:
- 平台可能限制抓取;
- Cookie 可能失效;
- 路由可能失效;
- 数据可能延迟;
- 稳定性无法保证。
某种意义上:它更像一种:“社区驱动的非官方解决方案”。 但是对于我我现在的场景来说:它已经足够用了。同时,RSSHub 支持的网站远不只是 X。这其实才是它真正有价值的地方。 因为你最后得到的,并不只是:“X 内容订阅”。而是:“一个统一的信息输入层”。
RSSHub 的核心概念与基本使用方式
当打开 RSSHub 的官方 Guide 时,会看到一个简单的示例,订阅 @awesomeRSSHub 在 Telegram 的频道,操作步骤如下:
- 通过查看 Telegram 的路由文档,确定 URL 的格式 :
/telegram/channel/:username/:routeParams?,- 其中:
- username
- 必填
- 频道 user name
- routeParams
- 可选
- 主要是一些过滤之类的字段,具体参考文档上的内容
- username
- 实例地址:
https://rsshub.app
最终拼接的完整地址是:https://rsshub.app/telegram/channel/awesomeRSSHub 在浏览器或者本地的RSS客户端打开后,如下图:
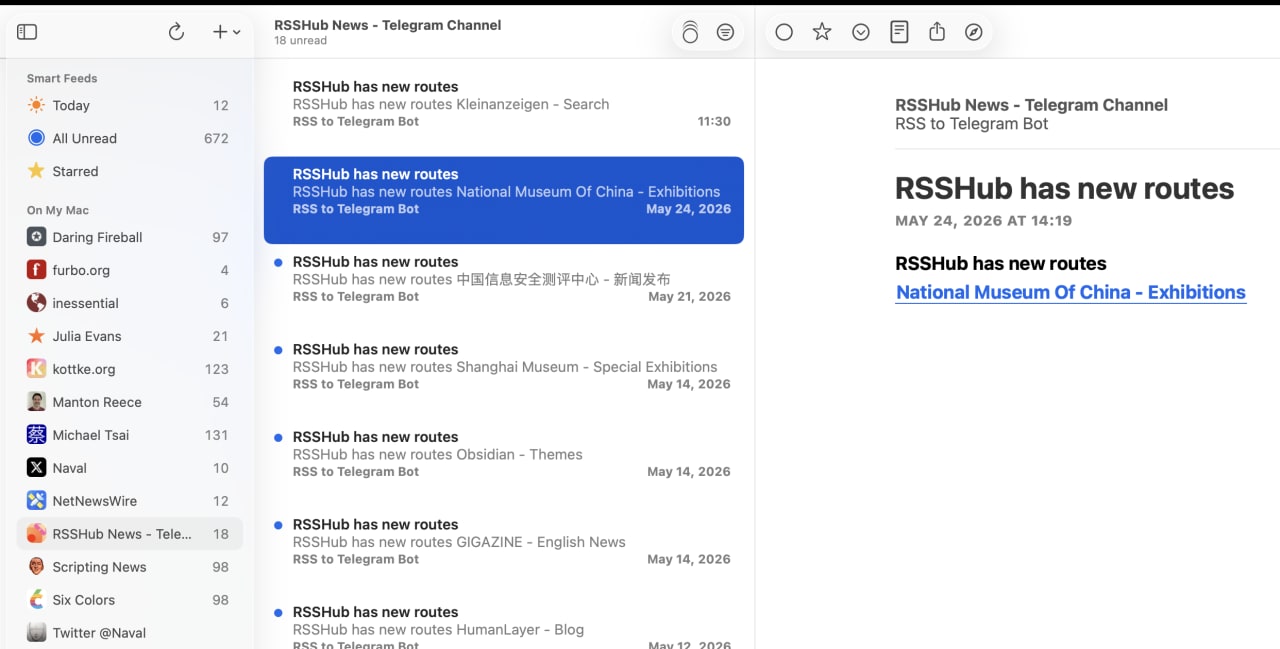
如果无法访问,可能是Instance服务器宕机或其他原因,访问公开实例列表,来查找其他 Online 状态为 up 的服务,将 URL 替换为对应的实例 URL,比如:https://rsshub.rssforever.com/telegram/channel/awesomeRSSHub
这个过程涉及如下的一些核心概念:
- Route:
/telegram/channel/:username- 可以理解为:某种网站内容的解析规则;
- 不同网站、不同页面类型,会对应不同 Route,比如:
/twitter/user/:id、/github/release/:user/:repo、/youtube/channel/:id- SSHub 内部维护了大量不同网站的解析逻辑。
- 参见RSSHub 提供的所有 Route 列表
- Instance
https://rsshub.app是官方实例- 任何人都可以部署自己的实例,上面的
rsshub.rssforever.com就是- 非官方公益提供,只要替换前面的 Instance URL 即可
- 参见RSSHub Instances 列表
- 公共 Instance 的问题:
- 不稳定,限流;
- Cookie 不共享;
- 部分 Route 被关闭;
- 隐私问题,抓取频率受限;
- 若是偶尔体验,公共实例够用,若长期使用,最适合的还是部署 Instance;
- Feed,
https://rsshub.app/telegram/channel/awesomeRSSHub- 最终需要订阅的RSS Feed 地址,;
- 在类似 NetNewsWire 的客户端软件中打开后直接使用
- RSSHub 已经把 Telegram 内容转换成了标准 RSS Feed。
- Parameters
- 允许对 Feed 做很多过滤与控制。
- 第一类:全局公共参数,例如:
limit,至获取最近5条briefmodereadable- Reader
- 第二类:Route 自定义参数,某个 Route 自行扩展,比如:
- X Route 中的:
- includeReplies
- includeRts
- 可以直接在线查看源码,比如:
- Twitter Route namespace.ts
- Twitter Route utils.ts
- X Route 中的:
- Output Formats,支持 RSS2.0、Atom、JSON Feed、RSS3 Protocol。使用方式直接在 URL 中增加
format参数即可。
debug.json 和 debug.html
- 需要实例开始
debugInfo=true - 用来帮助开发者来调试实例;
RSSHub 还提供兼容 Node.js 项目的 npm Package : rsshub,用来支持程序的调用。
pnpm add rsshubimport * as RSSHub from 'rsshub';
await RSSHub.init({
// config
});
RSSHub.request('/youtube/user/JFlaMusic')
.then((data) => {
console.log(data);
})
.catch((e) => {
console.log(e);
});