- MiniMax H3 是一个通用全模态生成系统;
- 支持对由文本、图像、视频和音频组成的多模态上下文进行统一理解生成视频;
- 结合官方API(闭源)可生成最高 2K分辨率;
- 独立部署的开源版本则是 768p 分辨率;
- 无论开源还是闭源,都是最长 15 秒、带原生立体声音频的视频;
相比典型的大语言模型推理,H3 是一个更复杂的多组件生成系统。除了核心 Transformer,还依赖 Text Encoder、Visual VAE、Audio VAE、Processor 和 Tokenizer 等组件协同工作。
模块组成
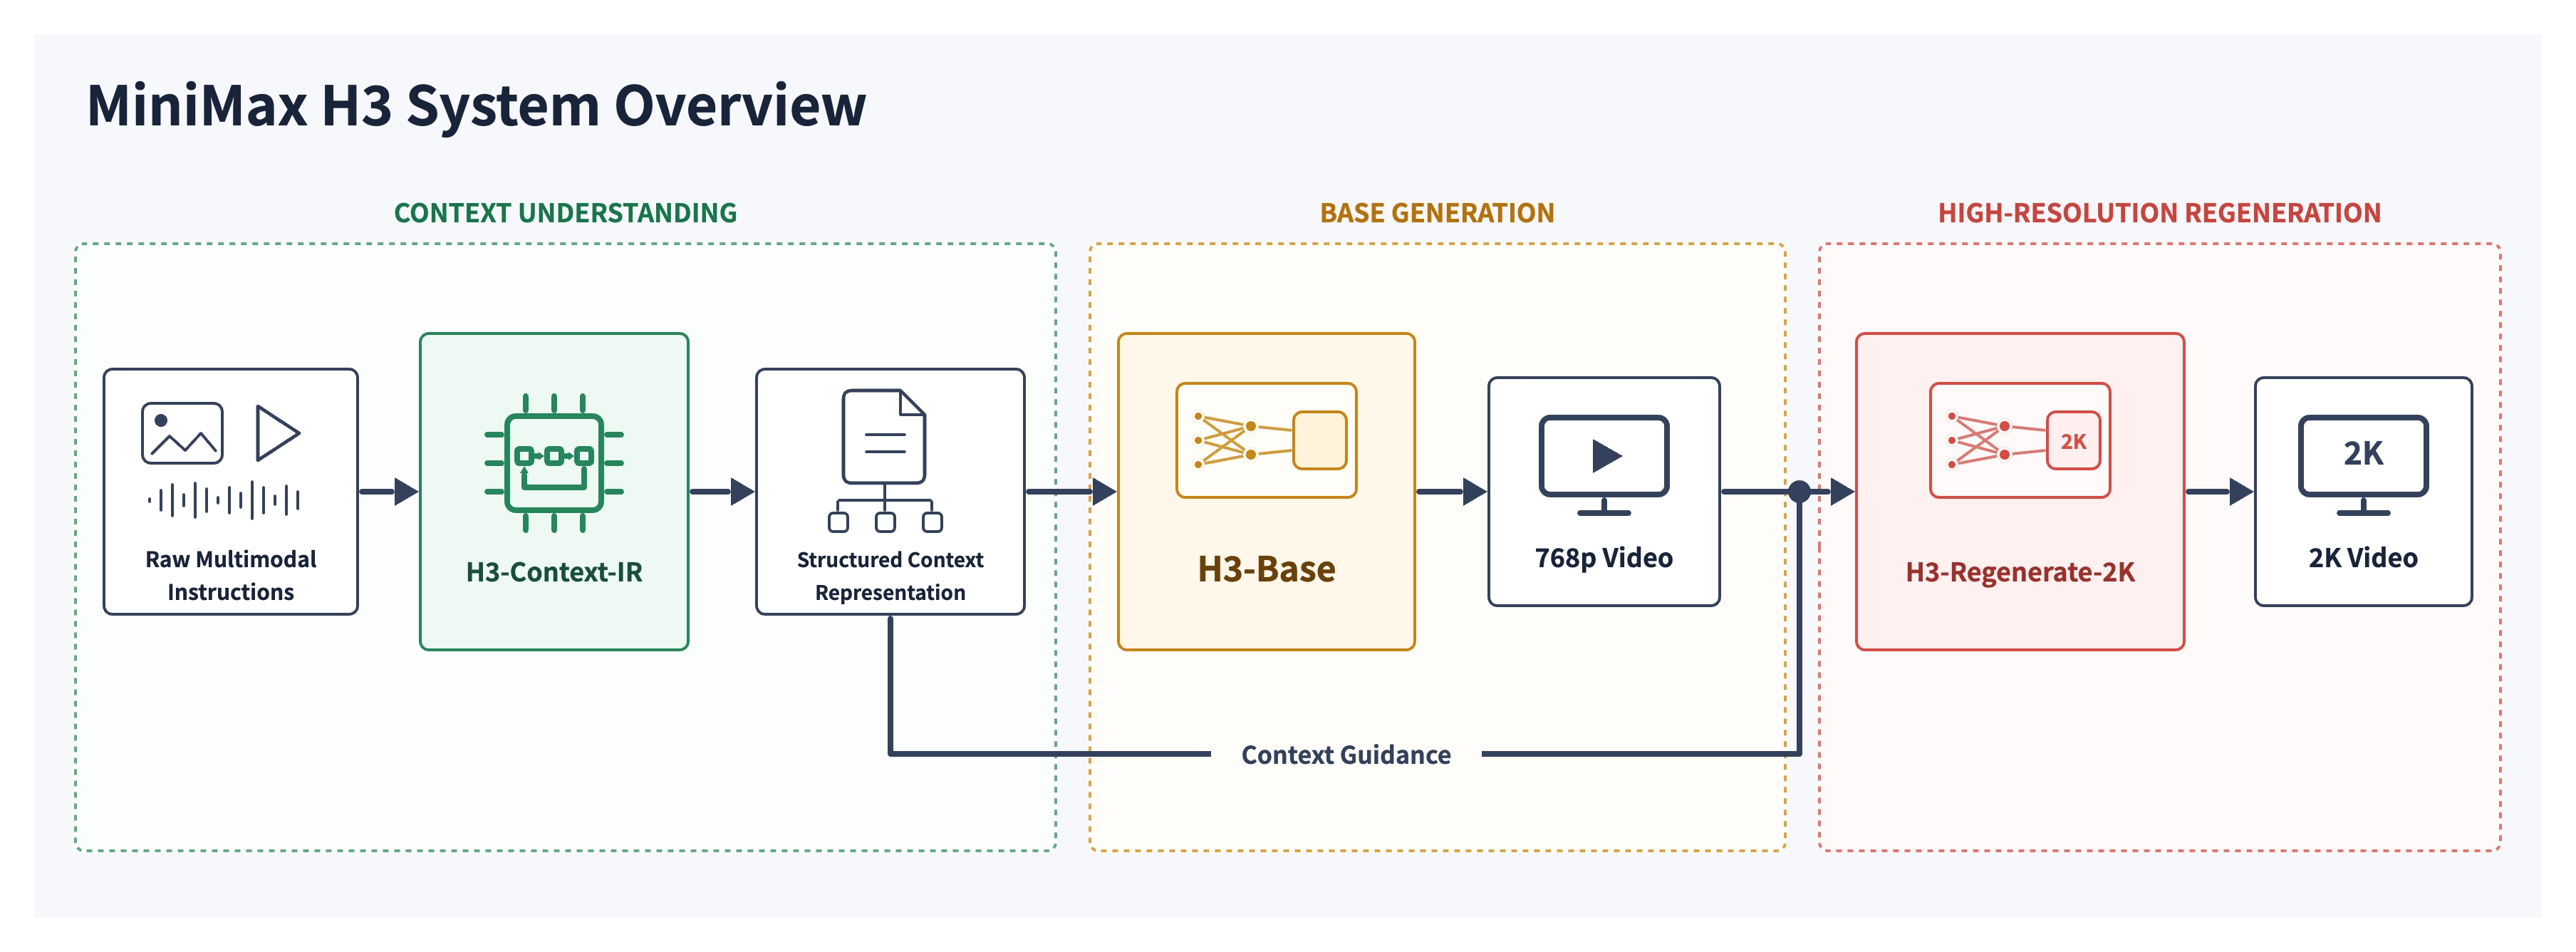
完整的 H3 系统由以下三个模块组成:
- H3-Context-IR,未开源:
- 一个托管式预处理与编排系统,把对上下文的理解序列化为 H3-Base 可接受的结构化表示,对输出质量至关重要,官方强烈建议集成到生产流水线;
- 依赖多阶段工作流以及多个托管模型和服务,因此不开源,需要调用官方 API :
- 输入价格:5.80 元/百万 tokens
- 输出价格:23.00 元/百万 tokens
- API 提供安全防护机制;
- 参考 推荐工作流 - 完整 2K 工作流 来复现官方工作流;
- 若不调用 API,可以通过“提示词指导“,即:h3-prompt-writing skill 来构建类似的上下文处理系统;
- H3-Base:
- 本次开源的核心内容,涵盖了Visual VAE 、Audio VAE、processor、tokenizer、text encoder、33B dense Omni Transformer Model 组件;
- 基于 H3-Context-IR 或 h3-prompt-writing skill 的输出生成音频和视频,产出 768p 分辨率结果。
- H3-Regenerate-2K,暂时未开源:
- 将 768p 结果与原始上下文一起调用,重新生成 2K 分辨率输出;
- 由于系统复杂度较高,该模块尚未开源,官方说会在准备就绪后发布;
- API 的价格由以下组成:
- 原始视频,768p -> 2k,0.30 元/秒;
- 输入图片,若有,超过5张 0.15元/张,5张内免费;
- 输入视频,若有,0.30 元/秒;
- 若不调用 API,可以尝试社区的做法,SeedVR2或者Latent 二次采样等;
输入和输出规格
| 类别 | 规格 |
|---|---|
| 输出时长 | 4–15 秒 |
| 输出宽高比 | 支持多种宽高比,包括但不限于 21:9、16:9、4:3、1:1、3:4 和 9:16 |
| 输出分辨率 | 支持多种分辨率尺寸。默认短边为 768 像素。可通过 H3-Regenerate-2K 实现 2K 生成 |
| 输出帧率 | 24 FPS |
| 输出音频 | 32 kHz 立体声 |
| 支持的对话语言 | 稳定支持 11 种语言:阿拉伯语、中文、英语、法语、德语、意大利语、日语、韩语、葡萄牙语、俄语和西班牙语。其他语言也有不同程度的支持 |
模型变体
| 模型变体 | 输入模式 | 规格 |
|---|---|---|
| H3-Base-FL2VA | 首尾帧模式 | 支持零张、一张或两张输入图像。 - 无图像输入:文生视频模式 - 一张图像输入:首帧生视频或尾帧生视频 - 两张图像输入:首尾帧生视频 |
| H3-Base-Ref2VA | 全参考模式 | 支持多模态参考输入: - 图像: ≤ 9 张 - 视频: ≤ 3 段;每段 2–15 秒;总时长 ≤ 15 秒 - 音频: ≤ 3 段;音频必须与图像或视频输入一起使用,不能作为唯一输入;每段 2–15 秒;总时长 ≤ 15 秒 - 混合输入: 所有输入类型的文件总数最多为 12 个 |
H3-Base
H3-Base 本身不是一个单独的模型权重,而是由 Encoder、VAE、Omni-Transformer、Tokenizer、Processor 等多个组件组成的完整生成模型系统。
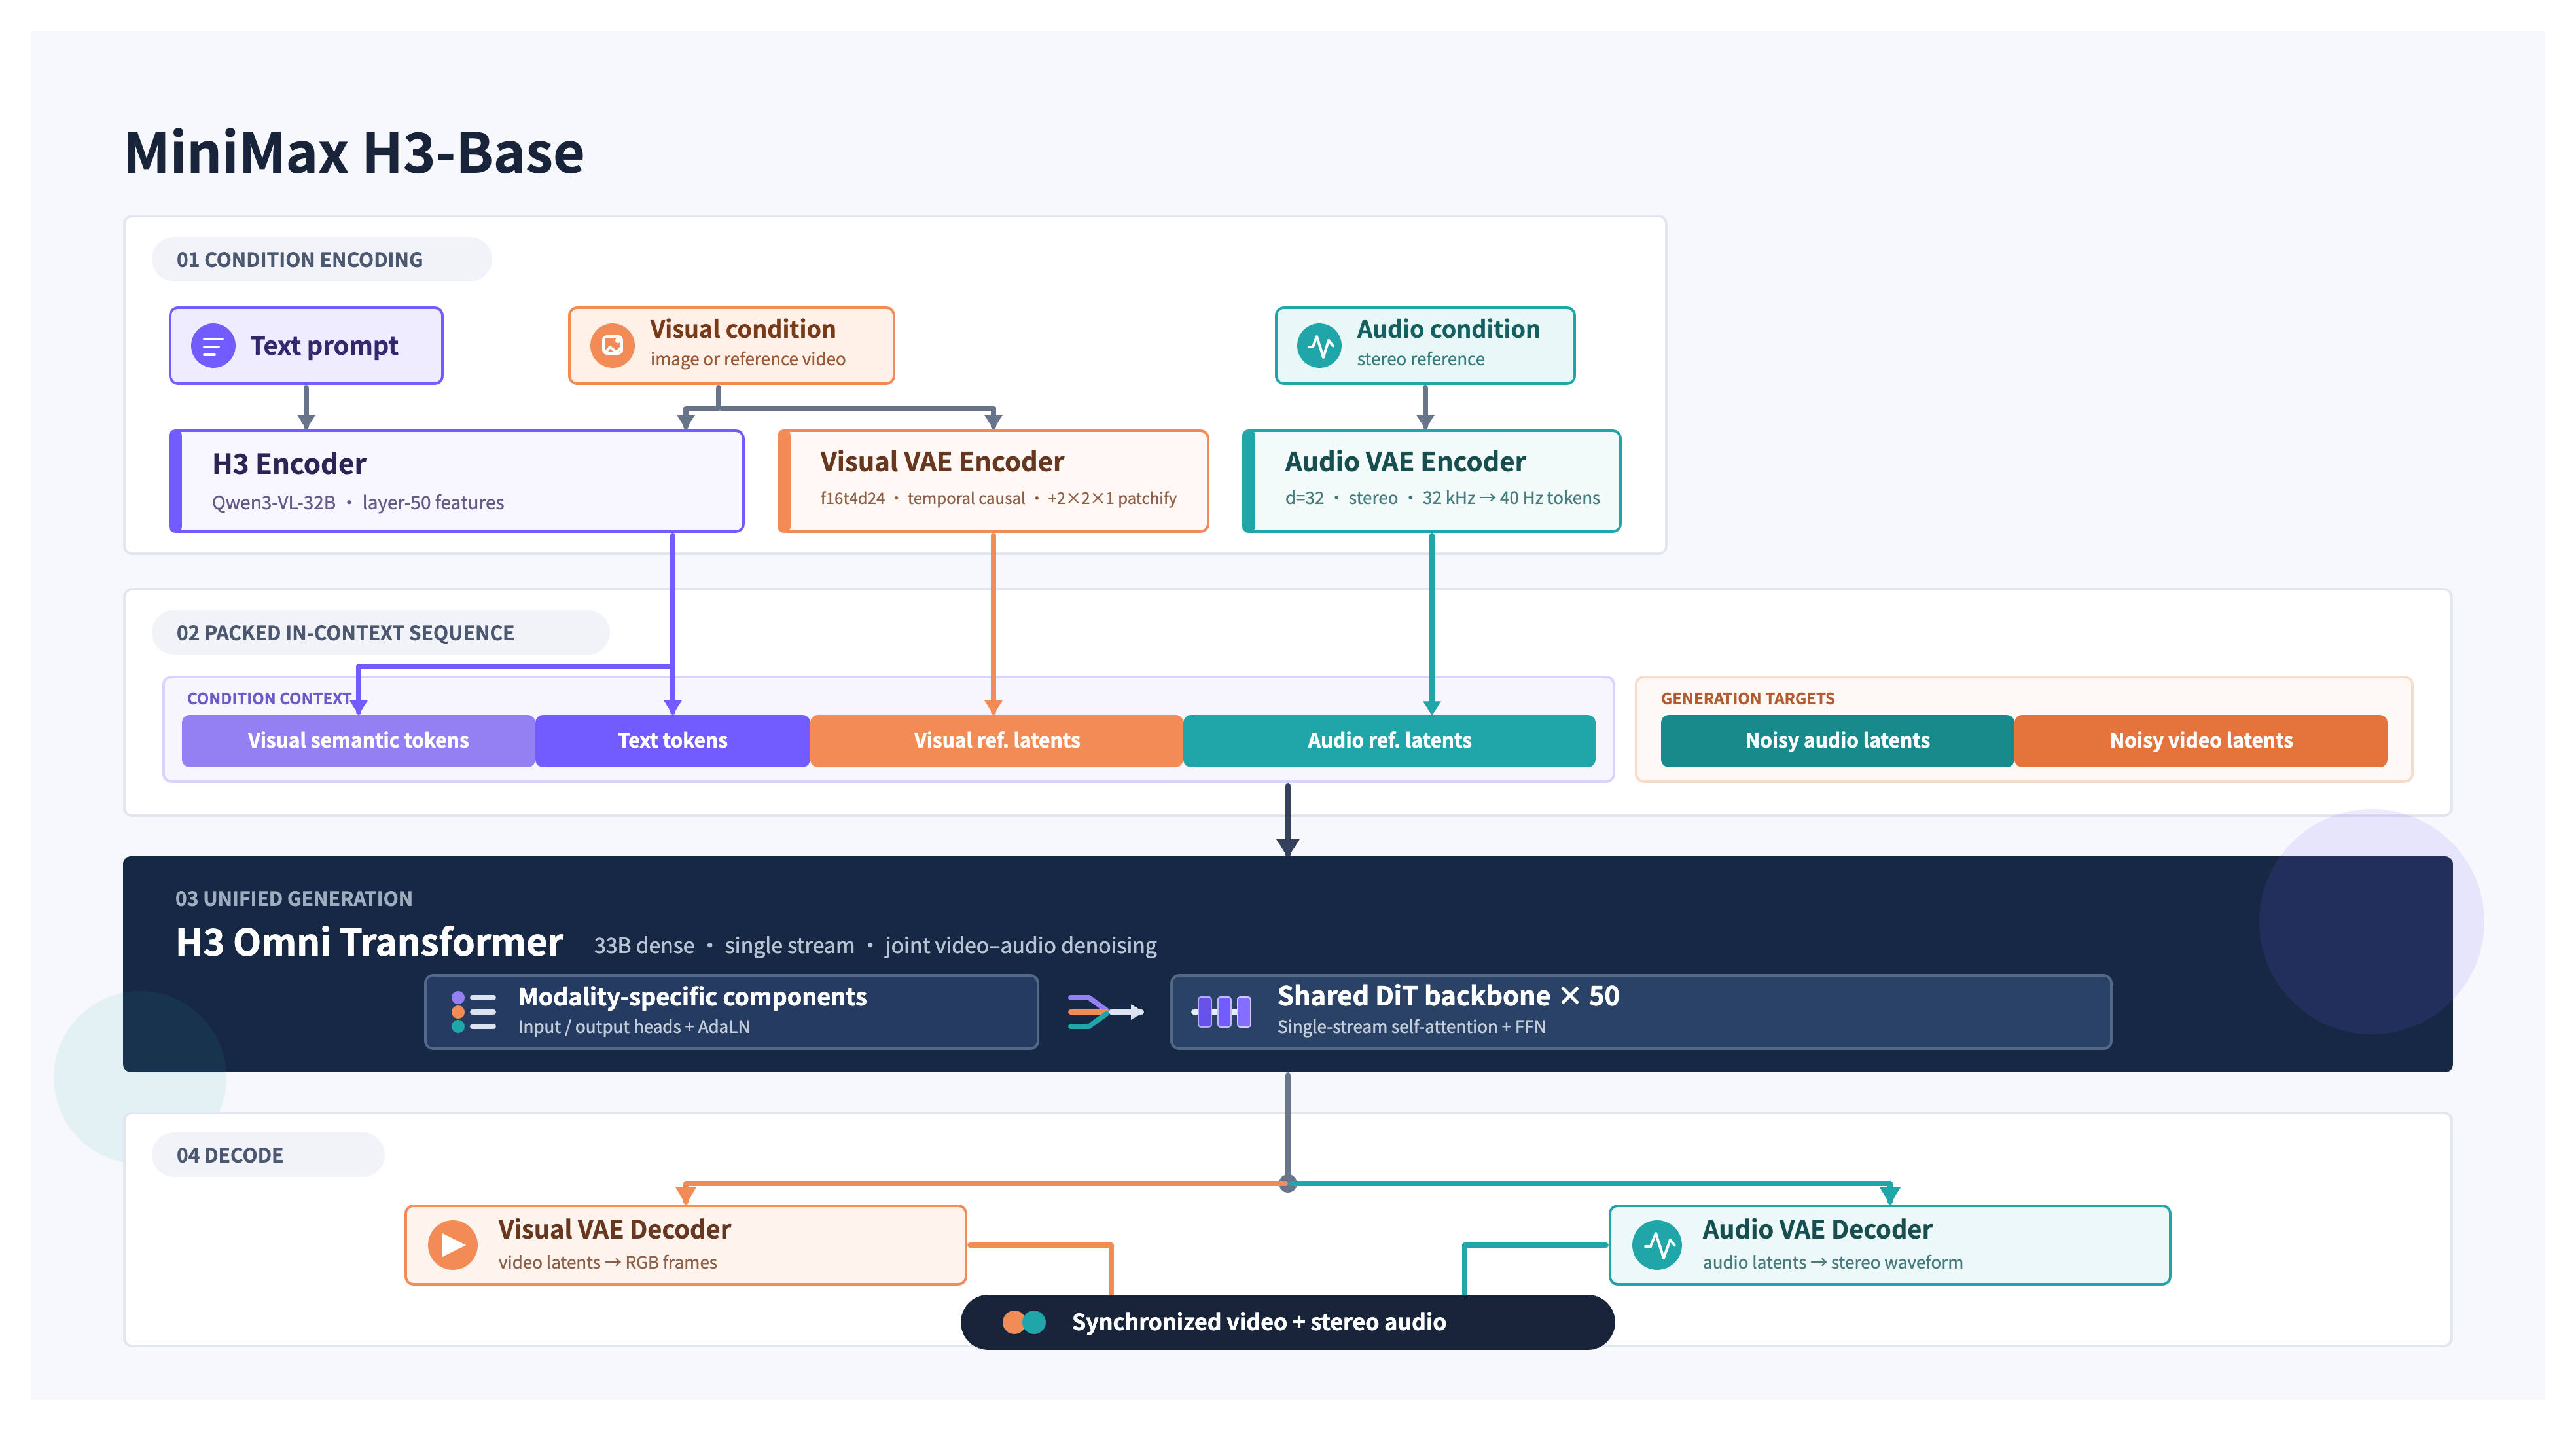
- H3-Base 使用 H3 Encoder、Visual VAE Encoder、Audio VAE Encoder 分别对文本、视频、音频进行编码,并将编码后的表示组织为统一打包的多模态序列;
- 文本由 H3-Encoder 编码;视觉输入由 H3-Encoder 和 H3-VisualVAE 共同编码;音频仅由 H3-AudioVAE 编码;
- H3-Omni-Transformer 联合预测视频和音频 latent,随后分别解码为视频和立体声音频;
H3-Encoder
H3-Encoder 基于 Qwen3-VL-32B,负责理解文本、图像等输入,并将处理后的特征提供给 H3-Omni-Transformer,用于后续的视频和音频生成。
- 使用 Qwen3-VL-32B 的完整预训练权重,负责理解输入的文本、图像等内容,并把它们转换成 H3 主模型(H3-Omni-Transformer)能够使用的特征表示;
- 关于“将其第 50 层的隐藏状态提供给 H3-Omni-Transformer”的理解:
- hidden state(隐藏状态),输入经过某一层处理后得到的内部特征数据;
- 本质上仍然是一堆 Tensor/数值。只是这些数值已经不是最开始简单的 Token 表示,而是经过几十层计算后,包含了模型对输入内容的某种理解;
- H3 没有使用 Qwen3-VL 最终输出的文字答案,而是从它内部第 50 层直接取出已经处理好的特征,交给视频生成主模型;
- Prompt / Image → H3-Encoder「理解输入」→ H3-Omni-Transformer「生成内容」→ VAE「转换成最终视频/音频」;
- 由于官方增加了若干特殊 token,使用 H3 时,需要使用 H3 仓库中提供的 tokenizer 及相关配置文件;
H3-VAE
VAE 的核心作用:H3-Omni-Transformer 不直接处理庞大的原始视频像素和音频采样点,而是先通过 VAE 将它们压缩成更紧凑的 latent(潜在表示),在 latent 空间中进行生成,最后再通过 VAE 解码为视频和音频。
latent 可以先简单理解为:原始视频或音频经过压缩后得到的内部特征表示。
真实世界的数据                         H3 内部处理的数据

视频 ──→ VisualVAE Encoder ──→ Visual Latent ──→ H3 主模型
                                                ↓
视频 ←── VisualVAE Decoder ←── Visual Latent ←──┘


音频 ──→ AudioVAE Encoder ───→ Audio Latent ───→ H3 主模型
                                                ↓
音频 ←── AudioVAE Decoder ←── Audio Latent ←────┘
几个基本认识:
- H3 不直接在原始视频和音频数据上生成,而是在压缩后的 latent 空间中生成。
- VisualVAE 负责视频与 Visual Latent 之间的编码和解码;AudioVAE 负责音频与 Audio Latent 之间的编码和解码。
- VisualVAE 会大幅压缩视频的空间和时间维度,从而减少 H3-Omni-Transformer 需要处理的数据量。
- Visual Latent 和 Audio Latent 是两套独立的表示,但由同一个 H3-Omni-Transformer 进行联合建模和生成。
H3-VisualVAE:f16t4d24
MiniMax 将 H3-VisualVAE 描述为:空间压缩因子为 16×,时间压缩因子为 4×,latent 通道数为 24,记作 f16t4d24。
f16t4d24 可以理解为 VisualVAE 如何压缩视频,以及压缩后的 latent 具有怎样的结构:
f16:空间维度(高度、宽度)分别压缩 16×
t4:时间维度压缩 4×
d24:压缩后的每个 latent 位置使用 **24 个特征值(channels)**表示原始视频可以粗略表示为:T × H × W × C
其中:
- T = Time,时间 / 帧
- H = Height,高度
- W = Width,宽度
- C = Channel,原始视频通常为 RGB 三个颜色通道
经过 VisualVAE 后,得到:T/4 × H/16 × W/16 × 24
假设输入视频为:100 帧 × 1088 × 1920
经过 VisualVAE 后,忽略边界帧等具体实现细节,可以粗略理解为:25 × 68 × 120 × 24
对应:
- 时间:100 / 4 = 25
- 高度:1088 / 16 = 68
- 宽度:1920 / 16 = 120
- 特征:24 个 latent channels
24 并不是再压缩 24 倍,可以理解为:VisualVAE 将原始视频中的大量像素、颜色、纹理、边缘等视觉信息,编码成更加紧凑的特征表示;每一个 latent 位置由 24 个数值共同描述其视觉特征。
因此,VisualVAE 的工作并不是简单地缩小视频分辨率,而是通过训练得到的神经网络,将原始视频信息编码到一个更小、更适合生成模型处理的 latent 空间中:
原始视频
T × H × W × RGB
↓
VisualVAE Encoder
↓
Visual Latent
T/4 × H/16 × W/16 × 24
↓
H3-Omni-Transformer
↓
Visual Latent
↓
VisualVAE Decoder
↓
最终视频
Visual Latent 在进入 H3-Omni-Transformer 前,还会经过 1 × 2 × 2 patchify,将相邻空间位置进一步组织为 Visual Token;这使视觉 token 相对于原始视频具有 32× 的有效空间下采样,而时间下采样仍为 4×。
H3-AudioVAE
AudioVAE 与 VisualVAE 的基本目的相同,只不过处理对象从视频变成了音频。
H3-AudioVAE 将 32 kHz 音频压缩成 40 Hz 的 latent token 序列。
32 kHz 表示每秒每个声道包含约 32,000 个原始音频采样点,而经过 AudioVAE 编码后,可以用每秒约 40 个 latent token 来表示:
原始音频
32,000 samples / 秒
↓
AudioVAE Encoder
↓
Audio Latent
约 40 latent tokens / 秒
↓
H3-Omni-Transformer
这样 H3-Omni-Transformer 同样不需要直接处理数量庞大的原始音频采样点。
对于立体声音频,AudioVAE 使用相同的编码器和解码器分别处理左右声道,解码后再将两个声道重新组合成立体声音频。
Visual Latent 与 Audio Latent
H3 分别使用 Visual Latent 和 Audio Latent 表示视频和音频,但它们最终由同一个 H3-Omni-Transformer 进行联合建模:
              H3-Omni-Transformer
                ↙             ↘
        Visual Latent      Audio Latent
              ↓                 ↓
         VisualVAE          AudioVAE
              ↓                 ↓
            Video              Audio
这意味着 H3 的核心生成模型不是分别独立生成视频和音频后再简单拼接,而是在统一的生成模型中同时建模视觉与音频信息,使人物动作、嘴型、语音、环境声音等不同模态之间能够建立联系。
一句话理解:VAE 负责“压缩和还原”,H3-Omni-Transformer 负责在压缩后的 Visual / Audio Latent 空间中进行真正的内容生成。
H3-Omni-Transformer
H3-Omni-Transformer 是 H3-Base 的核心生成模型。
前面的 H3-Encoder、VisualVAE 和 AudioVAE 主要负责将文本、图像、视频和音频转换成模型可以处理的特征或 latent;真正负责联合生成视频和音频 latent 的,是 H3-Omni-Transformer。生成完成后,再分别通过 VisualVAE 和 AudioVAE 解码为最终的视频和音频。
H3-Omni-Transformer 是一个 33B 参数的稠密单流 Transformer,官方发布的 H3-Base checkpoint 使用 BF16 精度。
参数量与显存
BF16 中每个参数通常占约 2 Bytes,因此如果简单按照完整 33B 参数计算: 33B × 2 Bytes ≈ 66 GB,即完整 33B BF16 权重本身约需要 66 GB 存储空间。
不过,H3 有一个特殊设计:约 13B 参数位于 AdaLN 相关分支。这些参数的调制输出可以提前计算并缓存,因此在纯推理部署时无需加载,所以从纯推理角度,可以粗略理解为:
完整模型:33B
其中可在纯推理时省去:约 13B
实际需要加载的核心参数:约 20B

20B × 2 Bytes ≈ 40 GB
这里的 40 GB / 66 GB 都只是模型权重的理论体积估算,并不代表实际运行所需显存。
实际推理还需要额外空间,例如:
- 模型运行过程中产生的中间数据;
- Attention 等计算所需的显存;
- Visual / Audio Latent;
- 推理框架自身的开销。
同时,一个完整的 H3 checkpoint 也不只有 Omni Transformer,还包括:
processor
tokenizer
text_encoder
transformer
visual_vae
audio_vae
因此,部署 MiniMax H3 时不能只根据 33B × BF16 判断整套系统的显存需求。
在 H3 中的位置
对于普通用户,可以把整个 H3-Base 简化理解为:
H3-Encoder 和 VAE 负责准备数据,H3-Omni-Transformer 才是真正负责生成内容的主模型。
H3-Omni-Transformer 会同时预测 Visual Latent 和 Audio Latent,因此视频和音频不是两个完全独立的模型分别生成后再简单拼接,而是在同一个核心 Transformer 中进行联合建模。
一句话理解:H3-Omni-Transformer 是 H3-Base 中真正负责生成视频和音频内容的核心 33B Transformer,Encoder 和 VAE 都是围绕它完成输入准备和最终解码。